注: 这篇文章是我研究生时期(2013年!)写的,但至今仍然很受欢迎,被不少论文引用。所以我把它复制到了这个新博客上。请注意,如今已有更先进、可扩展的指纹识别系统,但这里仍然是一个很好的入门介绍和示例代码库。祝你阅读愉快!
我第一次试用 Shazam 时,彻底被震撼了。除了 GPS 和从楼梯上摔下来还能活下来之外,能从海量音频库中识别出一首歌,是我见过手机能做出的最不可思议的事情。这种识别通过一个叫做 音频指纹(audio fingerprinting) 的过程实现。例如:
经过几个周末钻研学术论文和写代码,我做出了 Dejavu 项目,一个用 Python 编写的开源音频指纹识别项目。你可以在 Github 上看到它。
在我的测试数据集上,Dejavu 在读取磁盘上的未知 wav 文件或收听至少 5 秒录音时,召回率达到 100%。
以下是理解音频指纹和识别所需的全部知识,从基础开始。有信号处理经验的读者可以直接跳到 “峰值查找” 部分。
音乐作为一种信号
作为一名计算机科学家,我对 快速傅里叶变换(FFT) 的熟悉程度仅限于它是一种在 $O(n\log(n))$ 时间内计算多项式乘法的巧妙方法。幸运的是,它在信号处理中的经典应用要酷得多。
音乐,实际上就是以一长串数字进行数字编码的。在未压缩的 .wav 文件中,这些数字非常多 —— 每个声道每秒 44100 个。这意味着 3 分钟长的歌曲有将近 1600 万个采样点:
$$
3 \text{ min} \times 60 \text{ sec} \times 44100 \text{ 采样/秒} \times 2 \text{ 声道} = 15{,}876{,}000 \text{ 个采样点}
$$
声道(channel)是扬声器可以播放的独立采样序列。想象你有两个耳塞 —— 这就是“立体声”,即双声道设置。仅有一个声道则称为“单声道”(mono)。如今现代环绕音响系统可以支持更多声道。但除非声音是以相同数量的声道录制或混音的,否则额外的扬声器是冗余的,一些扬声器只会播放与其他扬声器相同的采样流。
采样
为什么是每秒 44100 个采样点?这个数字看似随意,但它与 奈奎斯特-香农采样定理(Nyquist-Shannon Sampling Theorem) 有关。这是一个冗长的数学表述,说明在录音时我们能准确捕获的最高频率存在理论极限。这个最高频率取决于我们对信号采样的速度。
如果这难以理解,想想看一个每秒恰好旋转一周(1 Hz)的风扇叶片。现在想象你闭着眼睛,但每秒短暂地睁开一次。如果风扇恰好也是每秒完整旋转一周,那么它看起来就像没有动过一样!每次你睁开眼睛,叶片恰好都在同一个位置。但这里有个问题。事实上,据你所知,风扇叶片可能每秒旋转 0、1、2、3、10、100 甚至 100 万次,而你永远无法分辨 —— 它看起来仍然是静止的!因此,为了确保你正确地采样(或“看到”)更高频率(或“旋转”),你需要更频繁地采样(或“睁开眼睛”)。确切地说,我们需要以想要看到的频率的两倍频率进行采样,才能确保检测到它。
在录音的情况下,公认的规则是我们忽略 22050 Hz 以上的频率是可以接受的,因为人类甚至听不到 20000 Hz 以上的频率。因此根据奈奎斯特定理,我们必须以两倍的频率采样:
$$
\text{每秒所需采样数} = \text{最高频率} \times 2 = 22050 \times 2 = 44100
$$
MP3 格式对此进行压缩,以 1)节省硬盘空间,2)惹恼发烧友,但你电脑上的纯 .wav 文件只是一串 16 位整数(带有一个小头部)。
频谱图
由于这些采样点是一种信号,我们可以在歌曲采样的短时间窗口上反复使用 FFT,来创建歌曲的 频谱图(spectrogram)。这是 Robin Thicke 的《Blurred Lines》前几秒的频谱图。
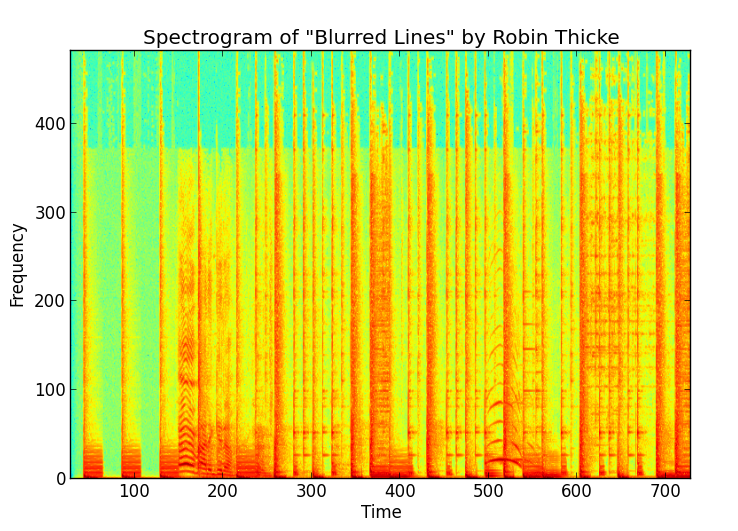
如你所见,它只是一个二维数组,振幅是时间和频率的函数。FFT 显示了该特定频率处信号的强度(振幅),给我们一列数据。如果我们用滑动窗口反复进行 FFT,将它们组合在一起就得到了一个二维数组频谱图。
重要的是要注意,频率和时间值是离散化的,每个代表一个“bin”(离散化时频坐标中的最小单位/格子/索引位置),而振幅是实数值。颜色显示了离散化(时间,频率)坐标处振幅的实数值(红色 → 更高,绿色 → 更低)。
作为一个思想实验,如果我们录制并创建一个单一音调的频谱图,我们会在该音调的频率处得到一条水平直线。这是因为频率在各个窗口之间没有变化。
很好。那么这如何帮助我们识别音频呢?嗯,我们希望使用这个频谱图来唯一标识这首歌。问题是,如果你的手机在车里,你试图识别收音机上的歌曲,你会得到噪声 —— 有人在背景中说话,另一辆车按喇叭等等。我们必须找到一种鲁棒的方法,从音频信号中捕获独特的“指纹”。
峰值查找
现在我们有了音频信号的频谱图,我们可以从寻找振幅中的“峰值”开始。我们将峰值定义为一个(时间,频率)对,其对应的振幅值在其周围的局部“邻域”中是最大的。它周围的其他(时间,频率)对的振幅较其更低,因此更不容易在噪声中存活。
查找峰值本身就是一个完整的问题。我最终将频谱图视为图像,使用图像处理工具包和来自 scipy 的技术来查找峰值。高通滤波器(突出高振幅)和 scipy 局部最大值结构的组合达到了目的。
一旦我们提取了这些抗噪声的峰值,我们就找到了歌曲中用于识别它的兴趣点。一旦找到峰值,我们实际上是在“压缩”频谱图。振幅已经完成了它们的使命,不再需要了。
让我们绘制它们看看效果:
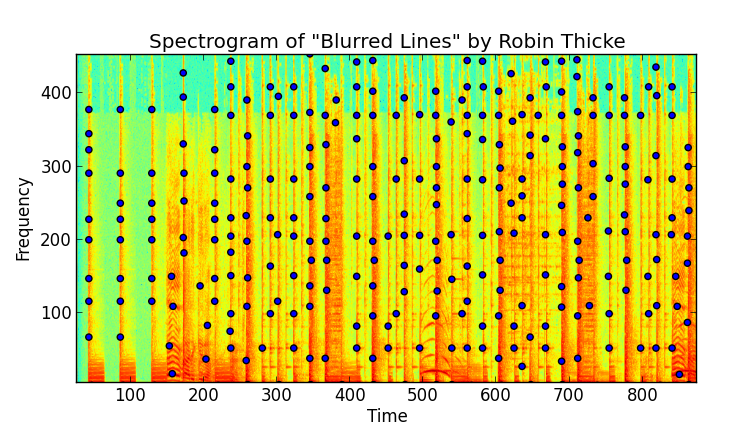
你会注意到这些点很多。实际上每首歌有数万个。美妙之处在于,由于我们已经去掉了振幅,我们只剩下两样东西:时间和频率,我们方便地将它们变成了离散的整数值。我们基本上对它们进行了分箱。
我们面临一种有点矛盾的情况:一方面,我们有一个系统,它将信号中的峰值分箱为离散的(时间,频率)对,给了我们一些在噪声中存活的余地。另一方面,由于我们进行了离散化,我们将峰值的信息从无限减少到了有限,这意味着在一首歌中找到的峰值可能会(提示:将会!)碰撞,发出与其他歌曲中提取的峰值相同的对。不同的歌曲可以并且很可能会发出相同的峰值!那现在怎么办?
指纹哈希
我们可能有相似的峰值。没问题,让我们把峰值组合成指纹!我们通过使用哈希函数来实现。
哈希函数 接受一个整数输入并返回另一个整数作为输出。美妙之处在于,一个好的哈希函数不仅每次输入相同时返回相同的输出整数,而且很少有不同输入会有相同的输出。
通过查看我们的频谱图峰值,并将峰值频率及其之间的时间差结合起来,我们可以创建一个哈希,代表这首歌的唯一指纹:
$$
\text{hash}(\text{峰值的频率}, \text{峰值之间的时间差}) = \text{指纹哈希值}
$$
有很多不同的方法可以做到这一点,Shazam 有他们自己的方法,SoundHound 有另一种,等等。你可以浏览我的源代码看看我是怎么做的,但关键是通过考虑不止单个峰值的值,你创建的指纹具有更多的熵,因此包含更多信息。因此它们是更强大的歌曲标识符,因为它们碰撞更少。
你可以通过下面放大标注的频谱图片段来可视化正在发生的事情:
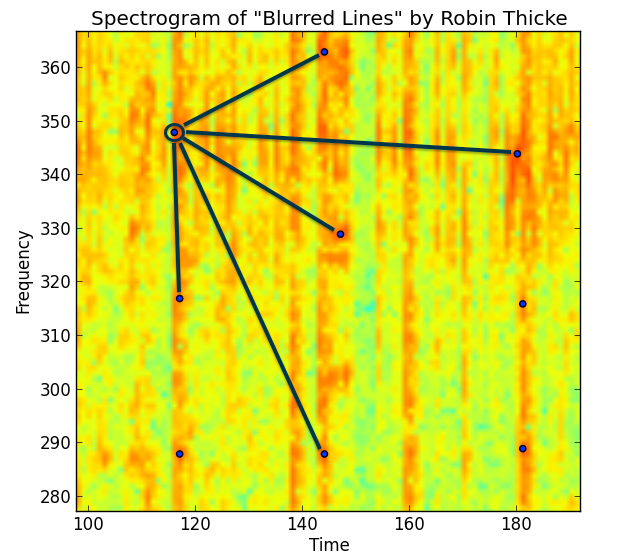
Shazam 的白皮书将这些峰值组合比作一种用于识别歌曲的峰值“星座”。实际上他们使用峰值对以及它们之间的时间差。你可以想象很多不同的方式来分组点和指纹。一方面,指纹中更多的峰值意味着更稀有的指纹,能更强地识别歌曲。但更多的峰值也意味着在噪声面前鲁棒性更低。
学习一首歌:数据库结构
现在我们可以开始了解这样的系统是如何工作的。一个音频指纹系统有两个任务:
- 通过指纹识别来学习新歌曲
- 通过在已学习歌曲的数据库中搜索来识别未知歌曲
为此,我们将使用目前为止的知识以及 MySQL 来实现数据库功能。我们的数据库模式将包含两个表:
fingerprintssongs
指纹表
指纹表将包含以下字段:
CREATE TABLE fingerprints (
    hash binary(10) not null,
    song_id mediumint unsigned not null,
    offset int unsigned not null,
    INDEX(hash),
    UNIQUE(song_id, offset, hash)
);
首先,注意我们不仅有哈希值和歌曲 ID,还有一个偏移量(offset)。这对应于哈希值来源的频谱图中的时间窗口。这在以后我们需要过滤匹配的哈希值时将发挥作用。只有“对齐”的哈希值才来自我们想要识别的真实信号(更多内容见下面的“指纹对齐”部分)。
其次,我们在哈希值上创建了一个 INDEX —— 有充分的理由。所有查询都需要匹配它,所以我们需要在那里快速检索。
接下来,UNIQUE 索引只是确保我们没有重复项。没有必要浪费空间或因为让重复项存在而带来过度的音频匹配。
如果你对我为什么使用 binary(10) 字段作为哈希值感到困惑,原因是我们将有很多这样的哈希值,减少空间是必须的。下面是每首歌指纹数量的图表:
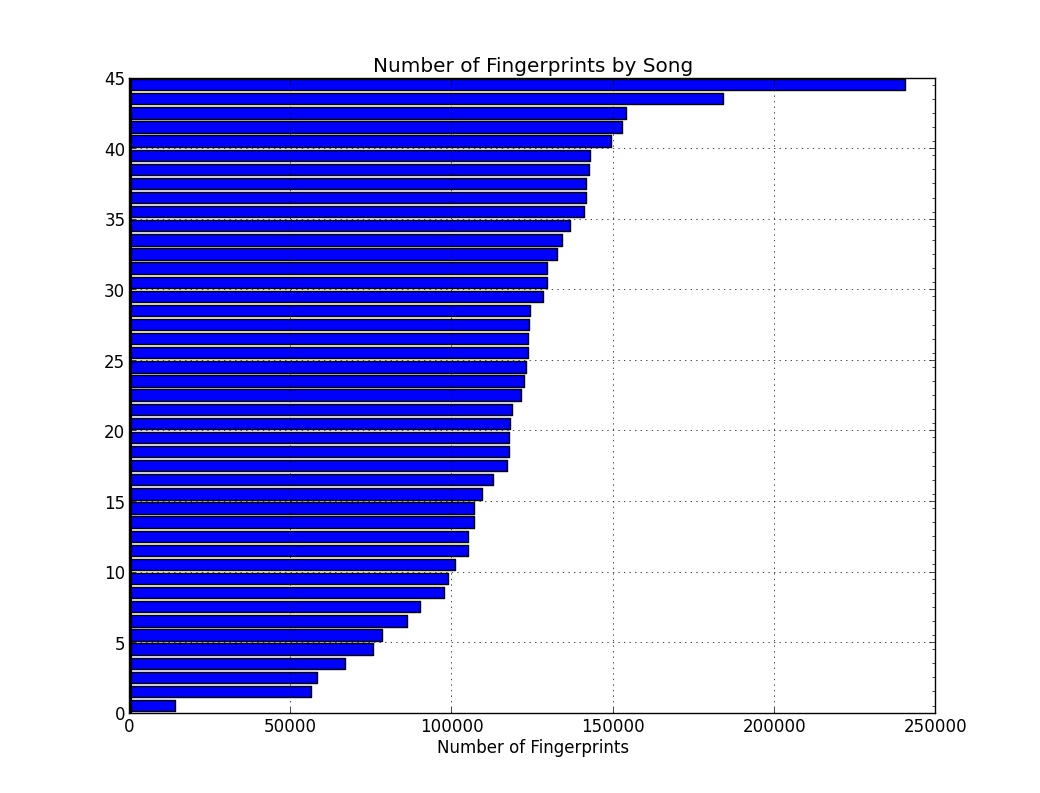
排在前面的是 Justin Timberlake 的《Mirrors》,有超过 24 万个指纹,紧随其后的是 Robin Thicke 的《Blurred Lines》,有 18 万个。排在最后的是无伴奏合唱《Cups》,这是一首器乐稀疏的歌曲 —— 只有人声和一个杯子。相比之下,听听《Mirrors》。你会注意到明显的“噪音墙”器乐编配填满了从高到低的频谱,意味着频谱图中高频率和低频率都充满了峰值。对于这个数据集,平均每首歌远远超过 10 万个指纹。
有这么多指纹,我们需要在哈希值层面减少不必要的磁盘存储。对于我们的指纹哈希,我们从使用 SHA-1 哈希开始,然后将其大小减半(只取前 20 个字符)。这将每个哈希的字节使用量减半:
$$
\text{char(40)} \Rightarrow \text{char(20)} \quad \text{从 40 字节到 20 字节}
$$
接下来,我们将这个十六进制编码转换为二进制,再次大幅减少空间:
$$
\text{char(20)} \Rightarrow \text{binary(10)} \quad \text{从 20 字节到 10 字节}
$$
好多了。我们将 hash 字段的 320 位降到了 80 位,减少了 75%。
我第一次尝试这个系统时,对每个哈希使用 char(40) 字段 —— 仅指纹就占用了超过 1 GB 的空间。使用 binary(10) 字段后,我们将表大小缩减到仅 377 MB,容纳了 520 万个指纹。
我们确实失去了一些信息 —— 从统计学上讲,我们的哈希值现在会碰撞得更频繁。我们大大降低了哈希的“熵”。然而,重要的是要记住,我们的熵(或信息)也包括 offset 字段,它是 4 字节。这使得我们每个指纹的总熵为:
$$
10 \text{ 字节(哈希)} + 4 \text{ 字节(偏移)} = 14 \text{ 字节} = 112 \text{ 位} = 2^{112} \approx 5.2 \times 10^{33} \text{ 种可能的指纹}
$$
还不错。我们节省了 75% 的空间,仍然拥有难以想象的大指纹空间可供使用。对键分布的保证是一个很难的论证,但我们肯定有足够的熵。
歌曲表
歌曲表将非常普通,基本上我们只用它来保存关于歌曲的信息。我们需要它将 song_id 与歌曲的字符串名称配对。
CREATE TABLE songs (
    song_id mediumint unsigned not null auto_increment,
    song_name varchar(250) not null,
    fingerprinted tinyint default 0,
    PRIMARY KEY (song_id),
    UNIQUE KEY song_id (song_id)
);
fingerprinted 标志由 Dejavu 内部使用,以决定是否对文件进行指纹识别。我们最初将位设置为 0,只有在指纹识别过程(通常是两个声道)完成后才将其设置为 1。
指纹对齐
好了,现在我们已经听完了一条音轨,在歌曲长度上对重叠窗口执行了 FFT,提取了峰值,并形成了指纹。现在呢?
假设我们已经对已知音轨执行了这种指纹识别,即我们已经将标有歌曲 ID 的指纹插入到数据库中,我们可以简单地匹配。
我们的伪代码大致如下:
channels = capture_audio()

fingerprints_matching = []
for channel_samples in channels:
    hashes = process_audio(channel_samples)
    fingerprints_matching += find_database_matches(hashes)

predicted_song = align_matches(fingerprints_matching)哈希值“对齐”意味着什么?让我们把我们正在听的样本视为原始音轨的一个子片段。一旦我们这样做,我们从样本中提取的哈希值将具有相对于样本起点的偏移量。
问题当然是,当我们最初进行指纹识别时,我们记录了哈希的绝对偏移量。来自样本的相对哈希值和来自数据库的绝对哈希值永远不会匹配,除非我们正好从歌曲的起点开始录音。这不太可能。
但虽然它们可能不相同,我们确实知道关于噪声背后真实信号的匹配的一些信息。我们知道所有相对偏移量之间的距离是相同的。这要求假设音轨以与录制和发行时相同的速度播放和采样。实际上,如果播放速度不同,我们无论如何都会倒霉,因为这会影响播放的频率,从而影响频谱图中的峰值。无论如何,播放速度假设是一个好的(也是重要的)假设。
在这个假设下,对于每个匹配,我们计算偏移量之间的差值:
$$
\text{差值} = \text{数据库中原始音轨的偏移量} - \text{录音的样本偏移量}
$$
这总是会产生一个正整数,因为数据库音轨总是至少与样本一样长。所有真正的匹配都将具有相同的差值。因此,我们来自数据库的匹配被改变为如下形式:
$$
(\text{song_id}, \text{差值})
$$
现在我们只需查看所有匹配,并根据最大差值计数来预测歌曲 ID。如果你将其可视化为直方图,这很容易想象。
就是这样!
效果如何
要真正获得音频指纹系统的优势,指纹识别不能花费太长时间。这用户体验很差,而且用户可能只决定在电台广告休息前用仅有的几秒钟音频来尝试匹配歌曲。
为了测试 Dejavu 的速度和准确性,我对 2013 年 7 月美国 VA Top 40 中的 45 首歌进行了指纹识别(我知道他们的计数有误)。我以三种方式进行了测试:
- 从磁盘读取原始 mp3 → wav 数据,以及
- 通过扬声器播放歌曲,Dejavu 在笔记本电脑麦克风上监听
- 在我的 iPhone 上播放压缩流媒体音乐
以下是结果。
1. 从磁盘读取
从磁盘读取取得了压倒性的 100% 召回率 —— 在我指纹识别的 45 首歌中没有犯任何错误。因为 Dejavu 从歌曲中获取所有采样点(没有噪声),如果从磁盘读取同一个文件都不能每次匹配,那将是一个令人讨厌的意外!
2. 通过笔记本电脑麦克风获得音频
在这里,我写了一个脚本,从原始 mp3 文件中随机选择 n 秒的音频来播放,并让 Dejavu 通过麦克风监听。为了公平起见,我只允许距离音轨开始/结束超过 10 秒的音频片段,以避免听到静音。
此外,我的朋友甚至在整个过程中说话,我也跟着哼唱了一点,只是为了加入一些噪声。
以下是不同监听时间(n)的结果:
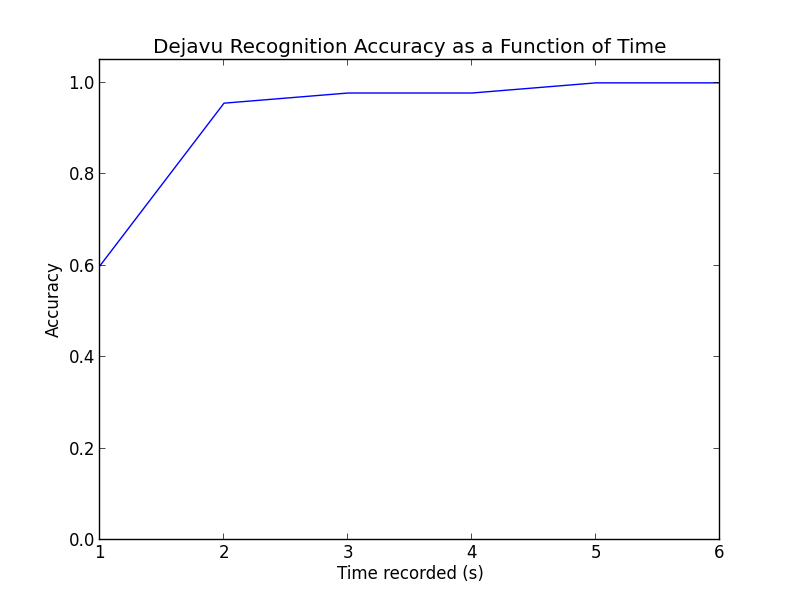
这相当棒。以百分比表示:
| 秒数 | 正确数量 | 准确率 |
|---|---|---|
| 1 | 27 / 45 | 60.0% |
| 2 | 43 / 45 | 95.6% |
| 3 | 44 / 45 | 97.8% |
| 4 | 44 / 45 | 97.8% |
| 5 | 45 / 45 | 100.0% |
| 6 | 45 / 45 | 100.0% |
即使是从歌曲中任意位置随机选取的仅有一秒的音频,Dejavu 也能达到 60% 的识别准确率!再增加一秒到 2 秒就能达到约 96%,而达到完美只需要 5 秒或更多。老实说,当我自己测试时,我发现 Dejavu 打败了我 —— 只听 1-2 秒的歌曲片段来识别是相当困难的。甚至在我为了调试已经听了这些歌曲两天的情况下……
总之,Dejavu 效果惊人,即使在几乎没有工作素材的情况下也是如此。
3. 在我的 iPhone 上播放压缩流媒体音乐
只是为了试试看,我尝试从我的 Spotify 账户(160 kbit/s 压缩)通过 iPhone 扬声器播放音乐,Dejavu 再次在我的 MacBook 麦克风上监听。我没有看到性能下降;1-2 秒就足以识别其中的任何歌曲。
性能:速度
在我的 MacBook Pro 上,匹配以 3 倍的监听速度完成,有很小的常数开销。为了测试,我尝试了不同的录音时间,并绘制了录音时间加上匹配时间的关系图。由于速度主要与特定歌曲无关,而更多取决于所创建频谱图的长度,所以我只在一首歌上进行了测试,Daft Punk 的《Get Lucky》:
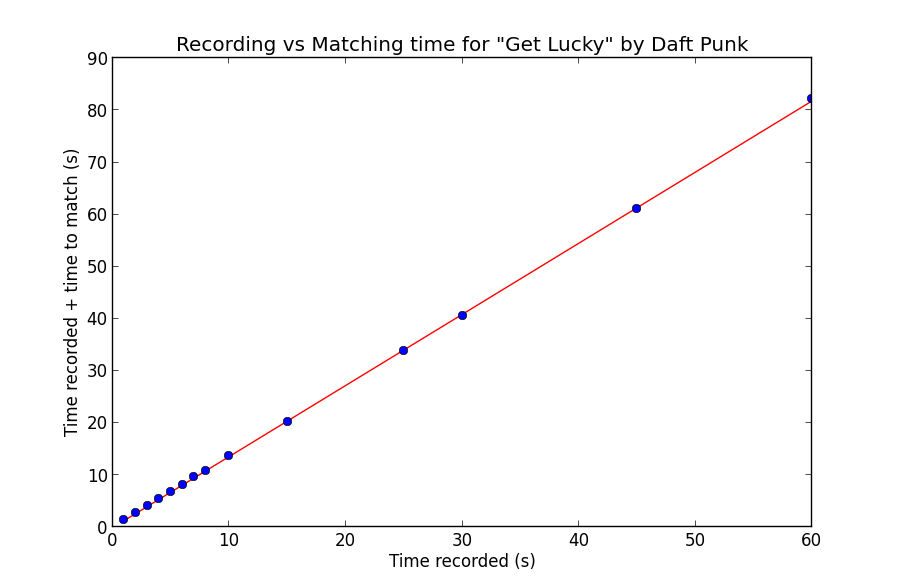
如你所见,关系相当线性。你看到的线是对数据进行最小二乘线性回归拟合,对应的线方程为:
$$
1.364757 \times \text{录音时间} - 0.034373 = \text{匹配时间}
$$
当然注意,由于匹配本身是单线程的,匹配时间包括录音时间。这与纯匹配中 3 倍的速度相符,因为:
$$
1 \text{(录音)} + \frac{1}{3} \text{(匹配)} = \frac{4}{3} \approx 1.364757
$$
如果我们忽略微小的常数项。
峰值查找的开销是瓶颈 —— 我用多线程和实时匹配进行了实验,唉,在 Python 中注定不行。等效的 Java 或 C/C++ 实现很可能在实时应用 FFT 和峰值查找方面不会有什么困难。
当然,一个重要的警告是进行匹配的往返时间(RTT)。由于我的 MySQL 实例是本地的,我不必处理通过网络传输指纹匹配的延迟惩罚。这将在整体计算中给常数项增加 RTT,但不会影响匹配过程。
性能:存储
对于我指纹识别的 45 首歌,数据库使用了 377 MB 的空间来存储 540 万个指纹。相比之下,磁盘使用情况如下:
| 音频信息类型 | 存储量(MB) |
|---|---|
| mp3 | 339 |
| wav | 1885 |
| 指纹 | 377 |
在必要的录音时间和所需的存储量之间存在相当直接的权衡。调整峰值的振幅阈值和指纹识别的扇形值将增加更多指纹,并在牺牲更多空间的情况下提高准确性。
确实,指纹占用了惊人的空间量(略多于原始 MP3 文件)。这看起来令人担忧,直到你考虑到每首歌有数万甚至数十万个哈希值。我们牺牲了波形文件中整个音频信号的原始信息,换来了仅占其存储量约 20% 的指纹。我们还实现了在五秒内非常可靠地匹配歌曲,所以我们的空间/速度权衡似乎得到了回报。
结论
音频指纹识别在我第一次看到时看起来像魔法一样。但只需少量关于信号处理和基础数学的知识,它就是一个相当容易理解的领域。
我希望任何读到这篇文章的人都能查看 Dejavu 项目并给我点几个 star,或者更好的是,fork 它!在这里查看 Dejavu:https://github.com/worldveil/dejavu